AI 真人短剧总像念台词?提示词不能只写“说什么”
- 2026-11-02 14:28:20
大家好,我是凯哥。前大厂研发工程师,转型做 AI 自媒体,1年做到全网 32 万粉。想做普通人跨过 AI 门槛的那把梯子。
用 AI 做真人视频,你是不是也遇到过这种情况:台词明明写得挺爽,人物一开口却像在念稿?
表情僵、接话慢、情绪也不对。重新生成几次,还是差点意思。
我这次拆解了一条 AI 真人怼人短剧的视频,就把这些问题几乎踩了个遍。
把测试版本和最终版放在一起看,我才发现:很多时候不是台词写得不好,而是提示词只写了“说什么”,没有写清楚“谁来说、怎么说、什么时候说”。
先看一下这条我做的视频:
整个制作流程并不复杂:先确定人物参考图,再把剧情、对白和表演要求写进视频提示词,生成片段后剪到一起。
这篇不重讲完整流程,我直接拿三组实际生成结果来对比:人物为什么不对味,表演方向为什么会跑偏,以及一句很爽的回怼,为什么会被 AI 演得拖拖拉拉。
第一个问题:人物生成得不难看,为什么还是不对味儿?
我最开始做过一版 30 岁都市白领。
短发、焦糖色西装、酒红色针织衫,生成质量其实不错。五官自然,服装也没有明显问题。
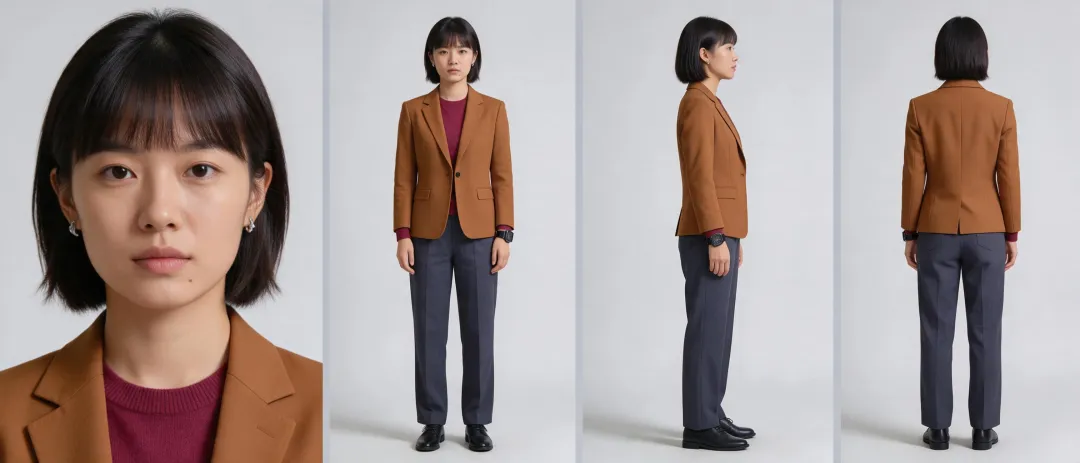
但把她放进这部短剧,我总觉得差点意思。
问题不在生成质量,而在人设方向。焦糖色西装加齐短发,给人的年龄感更成熟,也更像传统职场剧里的打工人。
让她说这些轻巧、带点玩味的回怼台词,不太搭。
后来,我把角色换成了更年轻的形象。短狼尾、蓝色挑染、黑银色短外套,再加上颈带和不对称耳饰。
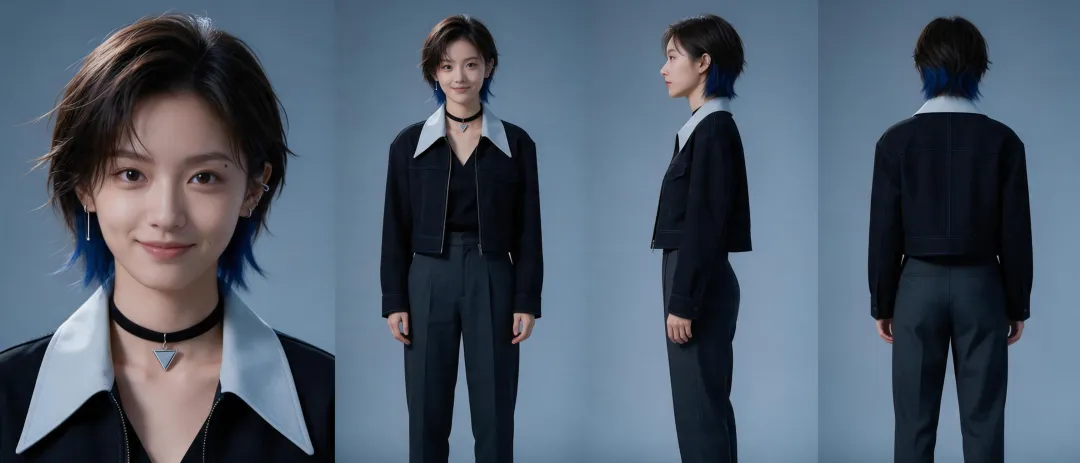
换完以后,我再看那些回怼台词,终于顺了。
她年轻、反应快,看起来有自己的边界,但又没有一张随时准备吵架的脸。后面那些带着笑意的回怼,放在她身上才不突兀。
人物参考图不是生成得漂亮就够了,它相当于短剧的选角。
年龄感、脸型、发型、服装和配饰,会提前告诉观众:这是一个什么样的人,她接下来会怎么说话。
最终人物四视图,我用的是下面这条提示词。图片模型选择 Seedream 5.0 Pro,比例选择 21:9。
生成一个年轻中国女性角色的四视图人物设定图。人物约 24 岁,年轻清秀的小巧脸型,短中庭,明亮灵动的杏眼,眼尾微微上扬,眉尾附近有一颗小痣,嘴角有浅酒窝;深棕黑色短层次狼尾发型,发梢轻微外翘,耳侧和后颈露出克制但醒目的钴蓝色内层染发。人物不是冷酷女强人,而是聪明、反应快、个性张扬、带一点叛逆感的年轻职场女性。她有很强的边界感,面对冒犯时不会忍气吞声。面部特写中直视镜头,嘴角带一丝若有若无的玩味笑意,像是已经看穿对方下一句话,但不做夸张表情。人物穿黑色短款结构感外套,带明显的深蓝色明线和宽大的浅冷灰色尖领;黑色内搭,黑色细绒颈圈,银色倒三角吊坠;一侧佩戴细长银色垂坠耳饰和小型耳骨夹,另一侧保持简洁,形成不对称设计。下装为深炭灰色高腰直筒长裤,搭配简洁的黑色尖头短靴。整体利落、年轻、前卫,但仍然符合现代办公室环境。画面比例 21:9。横向排列四个独立区域:第 1 格:面部特写,清楚展示五官、眉尾小痣、浅酒窝、蓝色内层染发、不对称耳饰、颈圈和三角吊坠;神态聪明、松弛,带轻微玩味笑意。第 2 格:正面全身,双臂自然下垂,姿态松弛自信,完整展示服装比例和身材轮廓。第 3 格:右侧面全身,标准侧身站立,展示狼尾发型层次、蓝色后颈挑染、外套侧面结构及裤装轮廓。第 4 格:背面全身,完整展示发型背面、蓝色内层染发、外套背面剪裁和整体身材比例。四格必须是完全同一个人物:五官、脸型、发型长度、挑染位置、服装、配饰和身材比例保持一致。冷灰蓝色摄影棚背景,柔和冷调自然光,皮肤真实细腻,有清晰眼神光。写实电影人物定妆照质感,不使用证件照式扁平光线。不要生成成熟行政人员气质,不要齐整的中分波波头,不要焦糖色西装,不要传统银行职业装,不要苦相或疲惫感,不要网红浓妆,不要僵硬站姿,不要文字、标签、水印或分隔标题。
提示词的最后这一段很重要。只告诉模型想要什么还不够,把第一版里不合适的东西写进禁止项,修改方向会更清楚。
第二个问题:生成得挺自然,为什么还是不对味儿?
第二组对比,先看一个饭局劝酒的片段。
男人把酒杯逼到女主面前,女主说自己吃了头孢,不能喝酒。男人不依不饶,还让周围的人一起起哄。
随后,酒杯里能看见两颗白色道具药片,女主再把酒杯举回男人嘴边。
这版其实不算失败。人物动作、镜头和反应都比较自然,只是女主一直比较严肃。
回头看提示词,这个结果并不意外:
女主气质冷静强硬。
女主主动逼近男人。
女主用男人刚才的姿态反过来压迫他。
这些描述和饭局冲突并不矛盾,但它们会把人物推向更紧张、更严肃的表演。
问题是,我后来确定的整部视频不是这个味道。
我想要的是女主不生气,也不摆出准备吵架的样子。她先听完,再用一点礼貌笑意、轻微玩味或者反问,把话轻松地送回去。
比如“接电话”这一段:
同事问她:
谁的电话啊?还背着我们接?
女主没有冷脸,也没有直接顶回去。提示词里写的是:
女主快速看一眼自己刻意躲开的走廊,再看回对方,眉毛极轻抬起,像不敢相信对方还没听懂边界。
她在对方话音落下后立即说道:「我都躲这儿了,你还以为是信号不好呢?」
“我都躲这儿了”清楚平稳,“信号不好呢”带一点轻微反问尾音。说完只停留很短时间,不切对手反应。
两个片段都可以很自然,但它们不是同一种表演。
头孢片段是严肃对抗,“接电话”是松弛反问。提示词里的情绪词、眼神和句尾语气,已经提前决定了女主会往哪边演。
AI 演得像真人,也不等于它演的是你想拍的那种短剧。
完整提示词也放这里:
总时长8秒,整体节奏自然偏快,像短视频里的真实交锋,不拖腔、不慢慢酝酿,但不能像机械高速念稿。对手说到后半句时,画面可以提前切到女主听反应,对手对白以画外音继续说完。对手最后一个字落下后,女主必须在0.1至0.15秒内直接接话,不增加单独的理解停顿镜头。不同人物的声音不能重叠。整体采用写实都市真人短剧质感,真实皮肤纹理、自然微表情和浅景深。主要使用稳定中近景、人物正反打和少量过肩构图。遵守180度轴线、视线方向、光向和空间关系。不使用快速推拉、环绕镜头、炫技变焦和慢动作。 图片1 是女主。0.0至0.4秒,开放式办公室外的安静走廊。女主刚刚接完私人电话,手机仍握在自己手中,准备返回办公区。一名约28岁的原创女同事站在办公区门边,戴细框眼镜,穿浅米色职业衬衫。她发现女主从远离人群的走廊回来,立刻带着过度好奇的表情探身询问。0.4至3秒,切戴眼镜女同事中近景。她盯着女主手里的手机,带着窥探隐私却自认为只是随口一问的语气说:“谁的电话啊?还背着我们接?”说到“背着我们接”时,画面提前切到女主近景。对手的后半句以画外音继续说完。女主已经看向同事。她的视线极快扫过自己特意躲开的走廊,再回到对方脸上,像是无法理解对方为什么还看不出自己的意思。不要低头沉思,不表现受伤或愤怒。3至8秒,保持女主近景。女主眉毛极轻地抬一下,使用正常音量、自然偏快的语速说道:“我都躲这儿了,你还以为是信号不好呢?”“我都躲这儿了”说得直接、自然,像在指出一个显而易见的事实。“你还以为”略带不可思议的反问感,眼神稳定地看着同事。“信号不好呢”使用很轻的疑问尾音,带一点干燥、克制的幽默感。嘴角可以出现极轻微的笑意,但不要大笑、冷笑、翻白眼或做出明显鄙夷表情。7.8至8.0秒,镜头在女主画面保持约0.2秒。她只维持原来的目光和神态,不新增动作,不切女同事尴尬、闭嘴、低头或离开的反应,画面直接结束。不要生成人物多手、多指、面孔融合、肢体穿插、人物分身和道具漂浮。不要生成字幕、标题、水印、二维码和复杂文字。不要使用美容滤镜、塑料皮肤或夸张喜剧表演。第三个问题:提示词没错,为什么成片还是不爽?
最后一组,是女主拒绝同事聚会邀请的片段。
同事问:
大家都去,就你不去,看不起我们?
女主回答:
别误会,我是听说你去,才不去的。
一开始是做了10秒的视频,感觉开头还可以,但女主听完以后停得太久,回答也被拉慢了。
整体看下来感觉节奏太慢了,那种“游刃有余”的感觉也没有了。
原因很简单,这种台词的爽感来自接得快。
对方刚把话说完,女主就已经听懂了,也已经想好怎么回。多等一秒,就会从“随口回怼”变成“认真组织语言”。
10 秒版的时间是这样分的:
0 至 1 秒:同事靠近。
1 至 4 秒:同事质问。
4 至 9 秒:女主回答。
9 至 10 秒:保留女主表情。
再看看后来修改的 7 秒版本,时间是这样分的:
0 至 1 秒:同事靠近。
1 至 3 秒:同事质问,说到后半句时提前切到女主的听反应。
3 至 6 秒:对方最后一个字落下,女主立即接话,不增加单独的理解和思考镜头。
6 至 7 秒:只保留很短的表情落点,直接结束。
下面是整理后的 7 秒完整提示词。为了方便公开展示,我把原提示词里小数级的时间要求改成了“立即接话”和“极短停留”,意思不变,也更容易直接套用。
总时长 7 秒,整体节奏自然偏快,像短视频里的真实交锋,不拖腔、不慢慢酝酿,但不能像机械高速念稿。对手说到后半句时,画面可以提前切到女主听反应,对手对白以画外音继续说完。对手最后一个字落下后,女主必须立即接话,不增加单独的理解停顿镜头。不同人物的声音不能重叠。整体采用写实都市真人短剧质感,真实皮肤纹理、自然微表情和浅景深。主要使用稳定中近景、人物正反打和少量过肩构图。遵守 180 度轴线、视线方向、光向和空间关系。不使用快速推拉、环绕镜头、炫技变焦和慢动作。图片 1 是女主。聚会邀请。0 至 1 秒:下班后的办公室出口。女主背着通勤包准备离开。一名约 28 岁的原创女同事从侧面靠近,拦在她前方,但不触碰或拉扯她。1 至 3 秒:女同事带着群体施压和质问的语气说:{大家都去,就你不去,看不起我们?}说到“看不起我们”时,画面提前切到女主中近景。女主已经看向她,安静听完,没有额外低头、眨眼或长时间思考。3 至 7 秒:保持女主中近景。女主立即接话,先用像在友好澄清的语气说“别误会”,嘴角带一点礼貌笑意;说到“我是听说你去”时,目光稳定地落在对方脸上,笑意变成轻微的玩味;最后用轻松、自然、不带怒气的语气落下“才不去的”。女主完整说道:{别误会,我是听说你去,才不去的。}不要把这句话演成愤怒攻击。“别误会”略柔和,“你去”轻微加重,“才不去的”语调自然下降,像随口说出一个让对方无法接话的事实。说完只保持原来的目光和轻微笑意,留下极短的表情落点,不新增动作,不切对手反应。不要生成人物多手、多指、面孔融合、肢体穿插、人物分身和道具漂浮。不要生成字幕、标题、水印、二维码和复杂文字。不要使用美容滤镜、塑料皮肤或夸张喜剧表演。怼人短剧的爽感,一半来自台词,一半来自接话的节奏。
提示词写得再完整,如果时长给得太长,模型还是会用停顿和多余反应把它填满。
现在写人物对话,我会检查这些
做完这几次测试,我不再把视频提示词当成剧情简介。它更像一张简化的导演单,人物听见什么、怎么反应、什么时候开口,都要交代。
现在写人物对话,我会按下面这个顺序检查:
人物:她是谁,外形和气质是什么。关系:谁在施压,谁暂时掌握主动权。刺激:对方做了什么,说了什么,离主角有多近。反应:主角先看哪里,身体怎样动,表情从什么状态开始。回应:多久接话,哪些字需要加重,句尾怎么落下。变化:一句话说到中间时,笑意、眼神和语气怎样改变。收尾:说完保留什么表情,镜头停多久,是否需要切对方反应。禁止:不要大喊、翻白眼、长时间思考、全程冷脸,也不要增加无关动作和对白。按这张清单检查,我至少能先拦住两个常见问题:人物从头到尾只有一种表情,对话之间又停得太久。
台词前后的反应,往往比台词本身更影响真人感。
写在最后
视频拆解里已经讲过怎么生图、怎么生成视频、怎么剪辑,这篇就不重复了。
我觉得把效果不好的版本和最终版放在一起看,反而更容易说明问题。
想看完整过程可以参考这个视频教程:
角色得像一个会说这句话的人,台词也得在对的时机说出来。两件事少一件,味道都会变。
在公众号后台回复关键词【AI】,可以领取这个视频的完整提示词。
感谢大家能看到最后,如果文章对你有帮助,记得一键三连:点赞、在看、分享。如果想第一时间收到推送,可以设为“星标”⭐️。
#AI视频 #AI教程 #AI自媒体 #真人短剧 #Seedance #提示词
📚 精选文章推荐

