用Hermes批量写短剧剧本:Agent驱动的结构化脚本生成
- 2026-11-06 11:38:14
用Hermes批量写短剧剧本:Agent驱动的结构化脚本生成
搭好环境只是第一步。这篇讲讲怎么写——从一句话梗概到完整JSON剧本,Writer Agent全部替你完成。
上一篇我们搭好了ComfyUI本地环境,跑通了第一张图。很多人停在这里——环境有了,但不知道下一步该干嘛。
其实真正的瓶颈不在生成端,而在内容端——**没有好剧本,设备也是空转**。这篇讲讲怎么写。
一句话梗概怎么变成完整剧本? 60集短剧的每集剧本怎么**批量生成**? 角色、场景、对话怎么结构化?
我花了两周时间调优,现在用Hermes Writer Agent可以自动生成结构化JSON剧本,直接喂给后续的图像和视频生成。
批量生成才是AI创作的核心价值。 —— 一个踩过坑的人
为什么剧本要结构化?
短剧不是小说,也不是电影剧本。它有自己独特的结构要求。
传统剧本格式自由,人可读就行。**但人工逐条写不现实**——Hermes要批量生成60集内容,每集十几张图片。
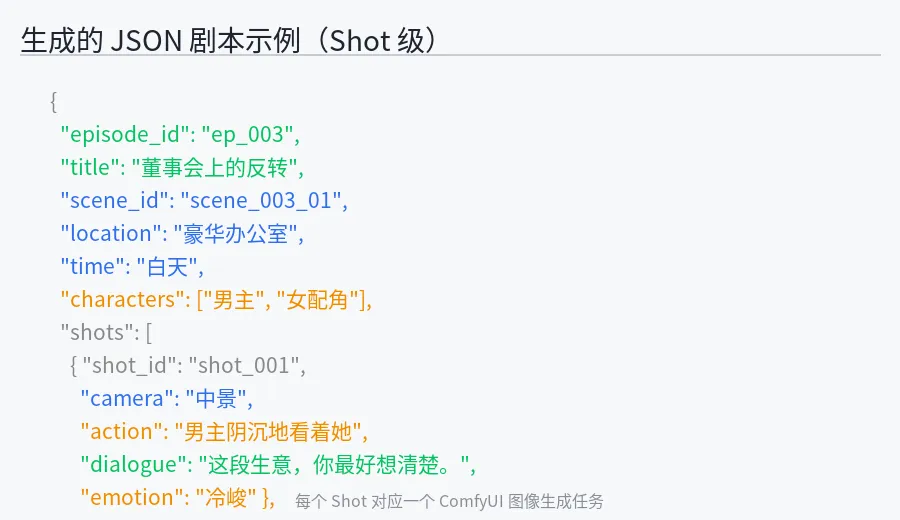
短剧剧本必须结构化,因为后续Agent要按字段读取,自动匹配ComfyUI工作流:
{ "episode_id": "ep_001", "scene_id": "scene_001_01", "location": "豪华办公室", "time": "白天", "characters": ["男主", "女配角"], "shots": [ { "shot_id": "shot_001", "camera": "中景", "action": "男主坐在办公桌前,脸色阴沉", "dialogue": "这段生意,你最好想清楚。", "emotion": "冷峻" } ] }JSON格式的三大优势:
一致性:同一角色的描述在所有Shot中保持一致 可迭代:不满意某集可以单独重写,不用推倒重来 机器可读:后续Agent直接按字段解析,不需要额外清洗
每个Shot对应一个图像/视频生成任务,所以字段要足够细致——**这是关键设计原则**。
Writer Agent架构
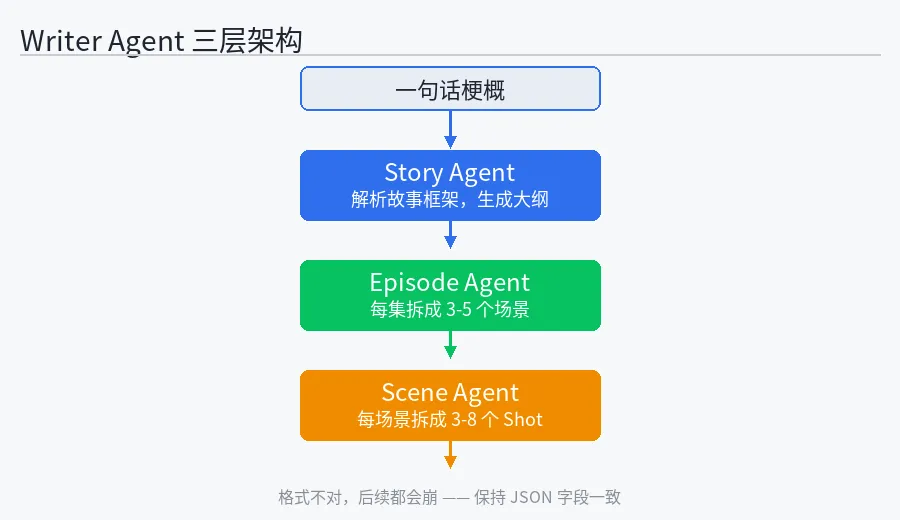
整个剧本生成流程分三层:
一句话梗概 │ ▼ ┌─────────────────┐ │ Story Agent │ 解析故事框架,生成大纲 └─────────────────┘ │ ├──→ episode_count = 60 │ ▼ ┌─────────────────┐ │ Episode Agent │ 每集拆成3-5个场景 └─────────────────┘ │ ▼ ┌─────────────────┐ │ Scene Agent │ 每场景拆成3-8个Shot └─────────────────┘本文只讲**Episode Agent和Scene Agent**,也就是核心剧本生成部分。
Story Agent负责把一句话梗概扩展成完整大纲,这一步你已经会了——上篇讲过。现在重点是怎么让Agent知道"第3集第2场"该写什么。
Episode Agent的输出是Scene Agent的输入,Scene Agent的输出是Image Agent的输入。**格式不对,后续都会崩**。
核心Prompt模板
Episode Agent Prompt
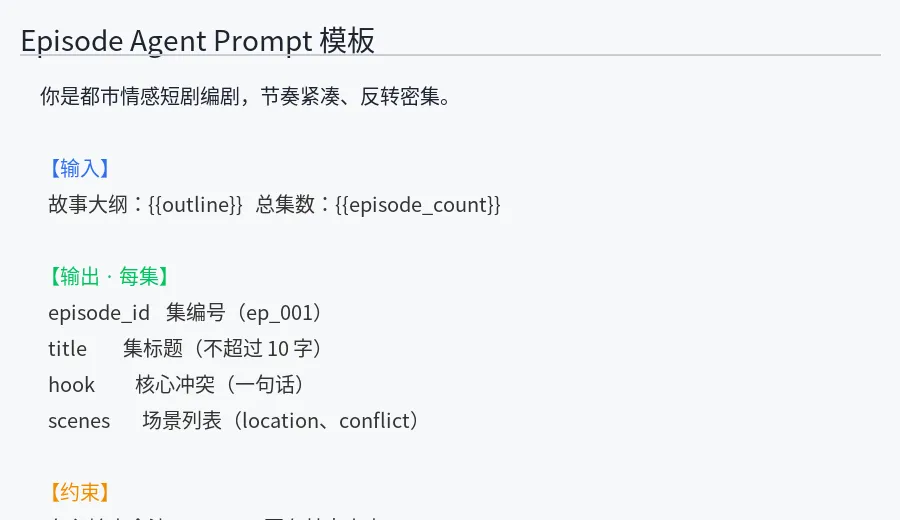
这是最关键的Prompt,决定了整部剧的骨架:
你是一个短剧剧本编剧,擅长创作节奏紧凑、反转密集的都市情感短剧。 【输入】 - 故事大纲:{{outline}} - 总集数:{{episode_count}} 【输出】 为每一集生成标题和核心冲突,格式如下: - episode_id: 集编号 - title: 集标题(不超过10字) - hook: 本集核心冲突(一句话) - scenes: 本集场景列表(每个场景含location、conflict)实测效果:60集大纲10秒生成,**质量稳定**。
Scene Agent Prompt
Scene Agent负责把每集拆解成具体镜头:
你是一个短剧分镜师,擅长设计戏剧张力和视觉冲击。 【输入】 - 本集大纲:{{episode_outline}} - 本集场景列表:{{scene_list}} 【输出】 为每个场景生成3-8个Shot,每个Shot包含: - shot_id: 镜头编号 - camera: 景别(远景/全景/中景/近景/特写) - action: 角色动作描述 - dialogue: 台词(如有) - emotion: 情绪关键词Episode Agent输出的场景太笼统,Image Agent没法直接用。**为什么需要Scene Agent?** 因为它把"两人在办公室吵架"拆解成具体镜头,每个镜头对应一张图。
三个关键改进点
1. 批量替换变量
Prompt里用`{{变量}}`占位,生成时批量替换。**比手动拼接字符串稳定**。
# 坏写法 prompt = "你是编剧,写" + episode_id + "集" # 好写法 prompt = template.replace("{{episode_id}}", episode_id)2. 强制JSON格式
很多模型输出不规范的JSON,导致后续解析失败。**解决方案有三**:
**方案一**:在Prompt末尾加"务必输出合法JSON,不要有其他内容" **方案二**:用正则表达式校验格式,不合法就重写 **方案三**:设置`response_format: json_object`(OpenAI兼容接口支持)
3. 分阶段细化
不要一次性生成完整剧本。**先粗后细**——分阶段生成比一口气跑完可控得多。具体做法:
第1步:生成故事大纲(Story Agent) 第2步:生成每集标题和冲突(Episode Agent) 第3步:生成场景列表 第4步:生成Shot级别剧本(Scene Agent)
每步都可以人工审核和修改。
常见问题与解决
质量不稳定?
同一组参数,有时生成效果好,有时差。**现象很明显**。原因是LLM有随机性,尤其是长文本生成。**解决方法**有三个:
固定`temperature=0.3`降低随机性 对每集生成3次,选最优 建立"好剧本模板库",让模型参考优质样本
60集一次性生成容易失控?
生成到第30集时,角色性格开始漂移。**现象很常见**,**原因**是上下文过长,模型"忘了"前面的设定。**解决方案**:
每5集重置一次角色设定 建立角色卡片(Character Card),每次生成前注入 分批次生成,不追求一口气跑完
JSON格式经常出错?
生成的JSON缺括号、引号不匹配、中文乱码——**现象**让人头疼。**解决方法**:
Prompt中强调"输出前检查格式" 用Python的`json.loads()`验证,失败重试 设置`max_tokens`不要太小,否则截断导致格式错误
下一步
剧本生成完了,接下来要做的就是**批量渲染**。
Image Agent会读取Shot级别的JSON,自动调用ComfyUI生成图片。这一步我们会讲到怎么把剧本自动翻译成Prompt,以及怎么处理角色一致性的问题。
批量生成才是AI创作的核心价值——不是为了省时间,而是为了做出一个人根本做不了的东西。
>
—— 一个踩过坑的人
觉得有用?点个关注,持续获取优质内容。

