把剧本交给OpenMontage,短剧能做到哪一步?【下篇】
- 2026-11-06 03:34:58
大家好,我是你的智能搭子阿洁。
上篇试完OpenMontage,我留下了三个明显的问题:手机聊天界面太简陋,场景之间缺动作,同一个人换镜头后,声音也不够一致。
这次我把《一盏灯,两种心动》的第一集重新做了一版,接出了约1分52秒的完整片子。头像和实体手机补上了,两个人各用固定声音,下车、走路、落座、停车也逐段重做。
精修版确实比上篇的初测版好了不少,但看完整集,我的判断是:它能帮我做出一版完整、可以继续剪的片子,目前这版短剧还达不到直接发布的效果,仍然需要人工剪辑。
结果比“让画面动起来”复杂得多:人从车里站起来了,后面还得走出画面;烤串举起来了,放下时还得找到盘子。
这期间,我还用OpenMontage做完了一条约4分59秒的PoseSwap横屏讲解。同一个工具,一边组织短剧补镜,一边把已有实测素材做成教程,两条制作过程正好放在一起看。
先看第一集重制版,再聊具体怎么改,以及讲解视频是怎样做出来的。
先说清楚,这次是谁在做什么
没看过上篇的朋友,可以把OpenMontage理解为一套给Agent使用的视频制作工程:把剧本、分镜、素材、生成任务和合成记录组织起来,方便继续修改。
我这次由Codex推进制作,本地ComfyUI里的H3负责生成动态镜头,Qwen3-TTS准备人物对白,Remotion负责剪辑、字幕和最终合成。OpenMontage把这些环节放进同一个项目里。
它的Backlot面板能查看阶段、分镜和素材。实际制作主要由Agent调用工具推进,操作方式和剪映那种手工时间线不同。
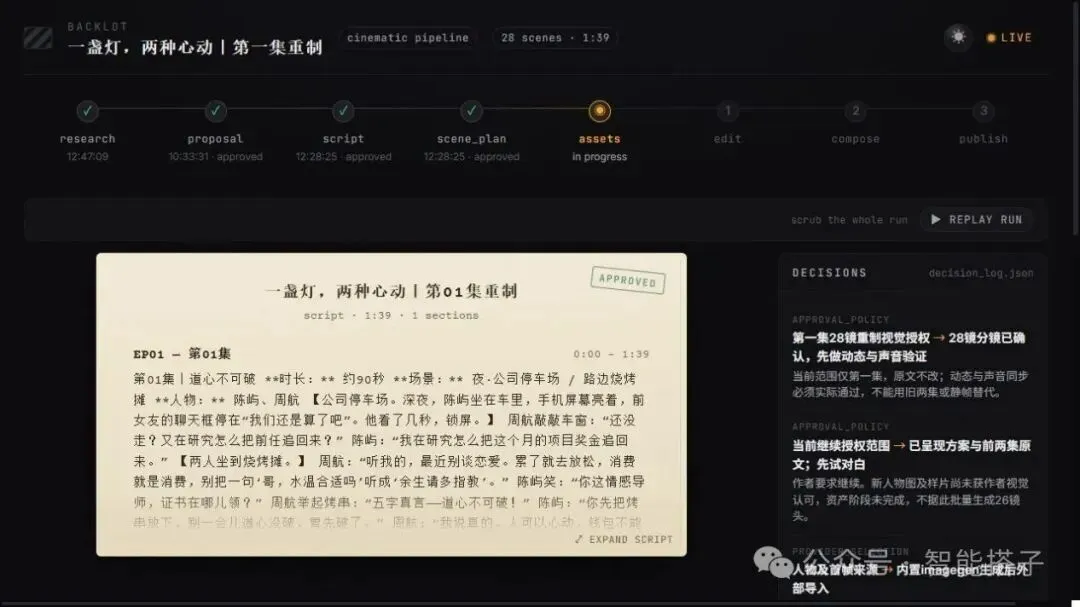
这里先按分镜安排制作,后来补足行走、拿放道具的过程,实际片长也随之增加。
这点会影响期待:看板里有一个完整项目,不代表下载后就能自动获得我本机的模型、声音和全部适配。想试同样的本地路线,需要先准备能运行的H3环境,再接入自己的素材和对白。
手机补上了,动作还得接着往下拍
第一集开头,陈屿收到一条“我们还是算了吧”的消息。这条消息交代人物状态,观众需要看清。
旧版在画面上放了一个简化聊天框。重做时,我把它放回剧情里的实体手机:手握着手机,消息带头像,再用人物反应和按侧键锁屏的镜头,把收到消息后的过程交代出来。
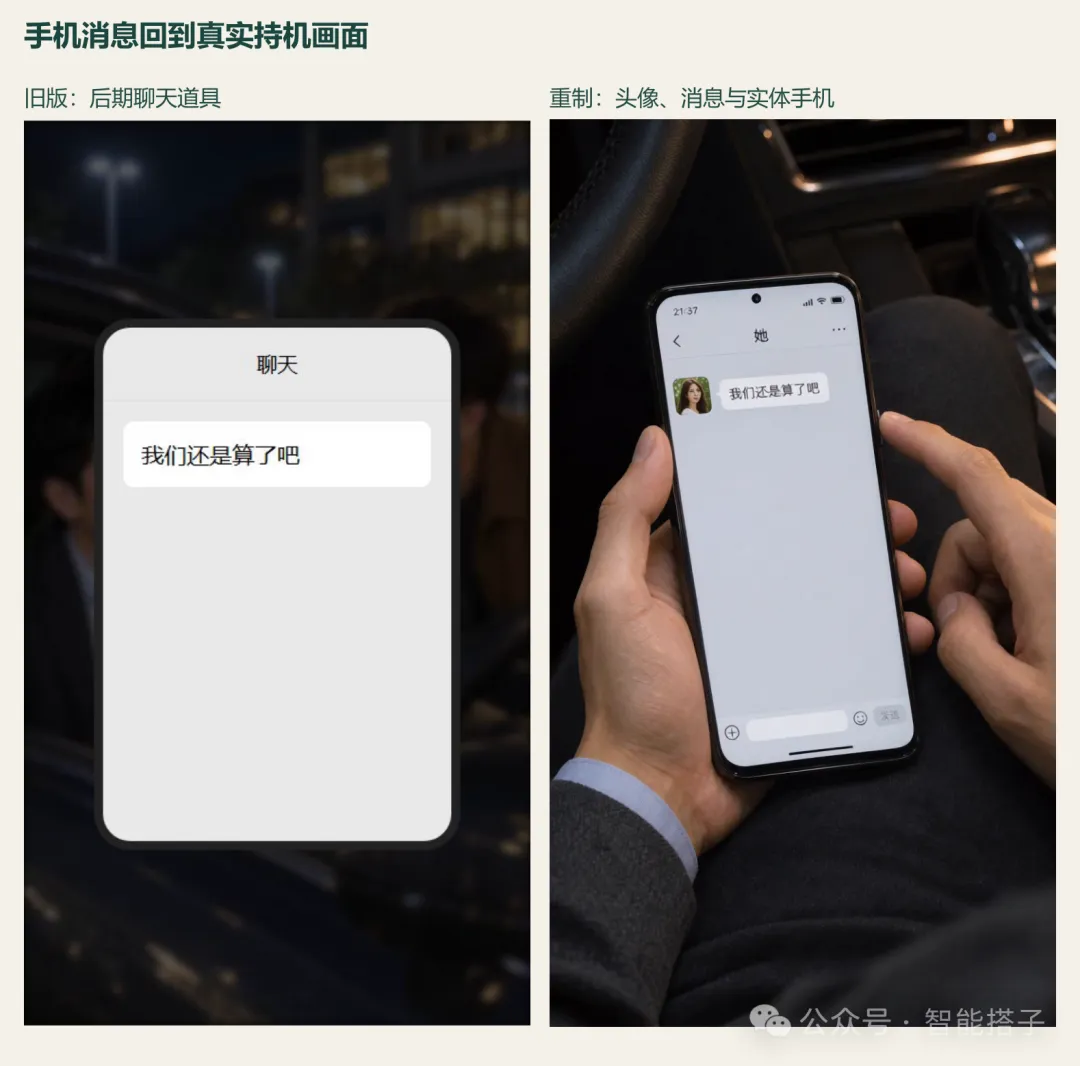
这里我先确定屏幕里的内容,再约束动作顺序:读消息、按侧键、屏幕变黑。原图和结束图分别固定亮屏、黑屏状态,减少生成时临时改消息、改界面的机会。
换场景时也遇到类似问题。中途一版已经有“下车”和“落座”,连起来看仍然跳:陈屿站到车外就切走了,下一场两个人直接坐在烧烤桌边。
后来补成了两段完整过程:停车场里,下车、关门、走几步,从右侧出画;到了烧烤摊,从左侧走入,再分别坐到桌子两边。
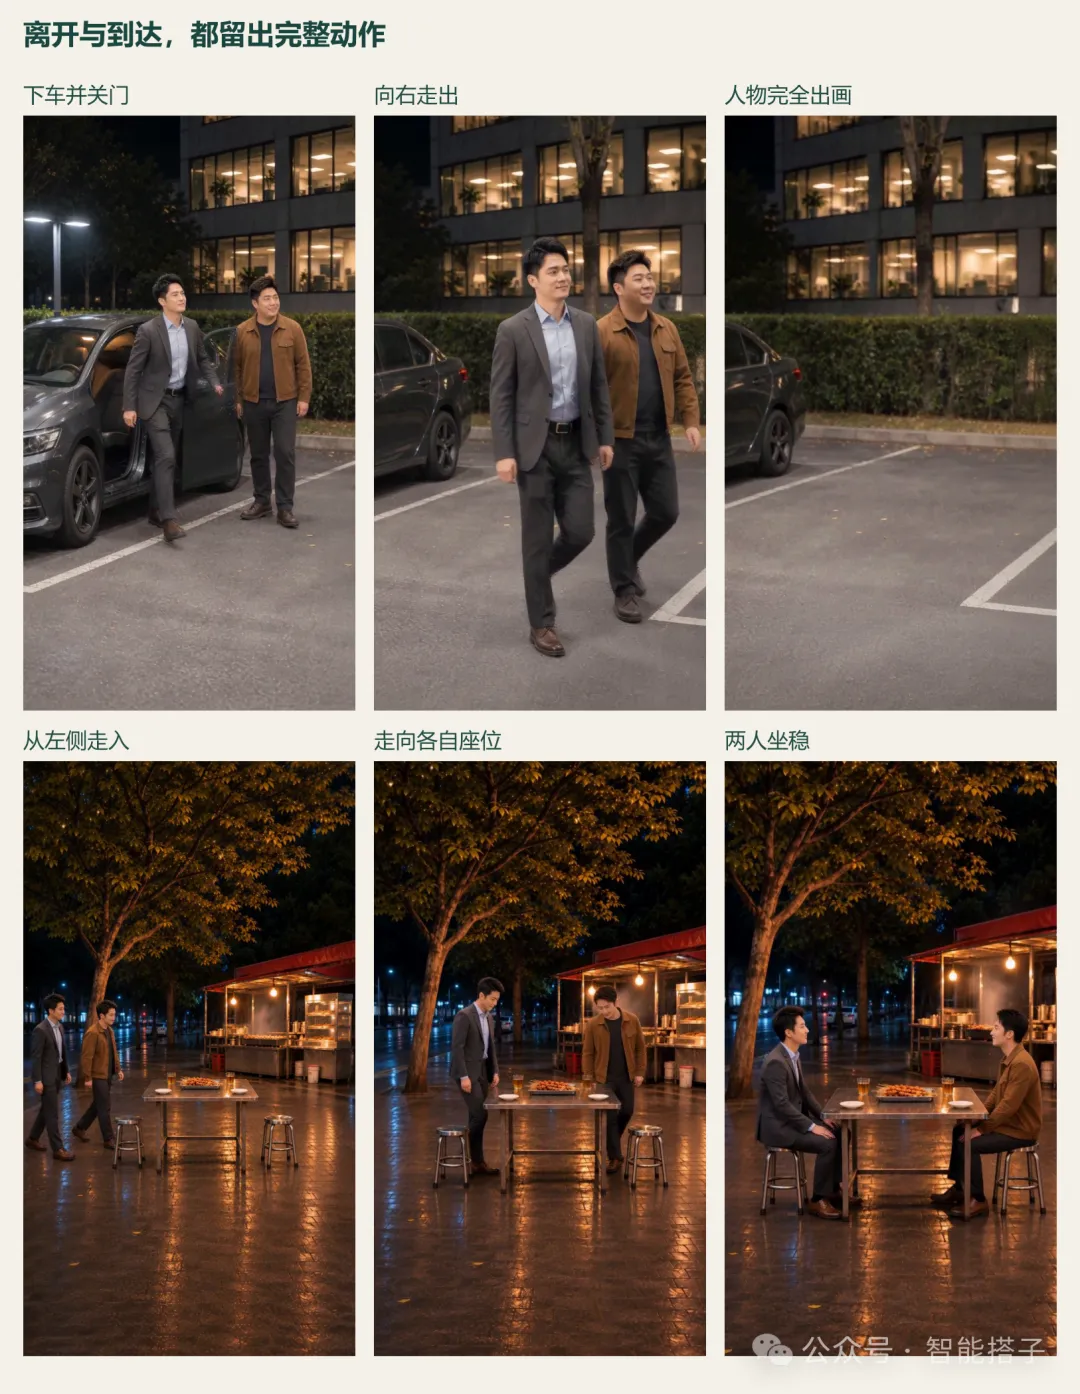
这次我检查一个动作,会连着看起点、过程和终点。只看到人站起来,还不足以交代他已经离开;落座前有走入画面的过程,两场之间就多了一点到达的感觉。
烤串放在哪儿,首帧就要安排好
烧烤段最具体的问题,是烤串直接放在了裸桌面上。
回头看首帧,道具位置已经错了。后面再要求“自然拿起烤串”,模型会沿着这个摆法继续动。
所以这轮先把首帧改成白瓷碟盛放烤串,再生成拿起和放回。周航的对白近景也同步补上餐碟,避免特写里有碟子,切回人物时又消失。
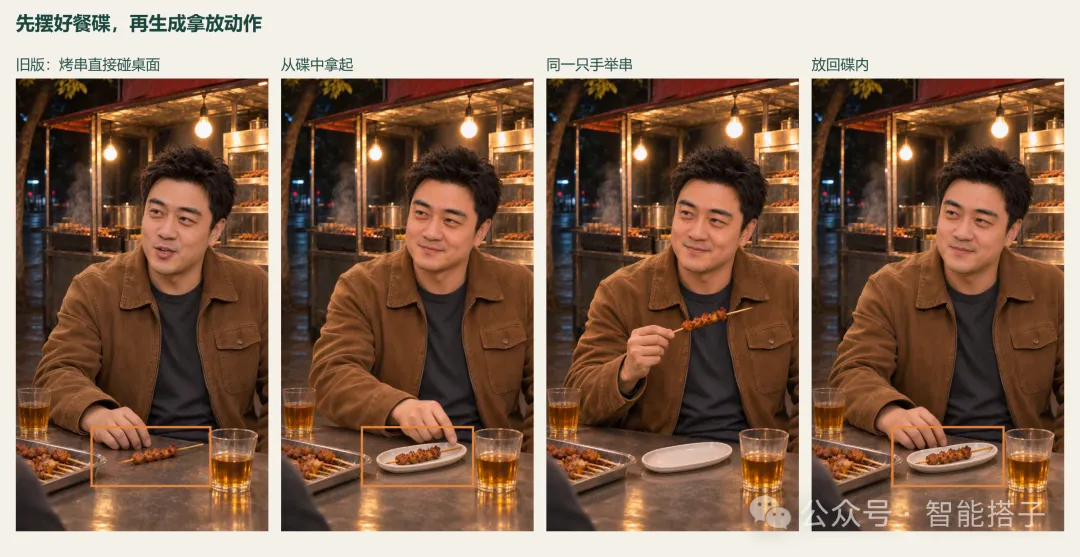
举串时还出现过换手,后来重新沿用原来的持串手。拿起、举着说话、放回碟子,才有机会接成同一个动作。
人物的脸、服装和场景要连续,道具的状态也得跟着连续。如果第一张图已经和剧情要求矛盾,我会先修图,再跑视频。否则出片以后,往往要连着返工好几个镜头。
停车段,先把车和门店的位置定下来
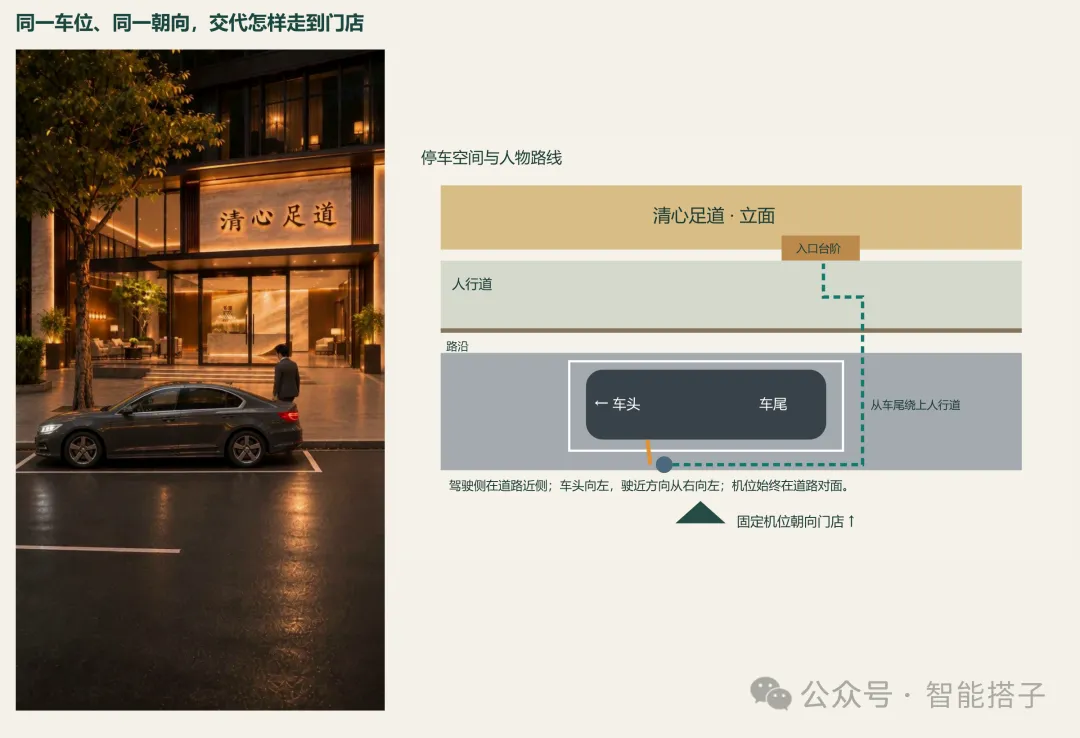
停车比预想中更费事。单条片里,车看起来停稳了;换到下车镜头,车头朝向、驾驶门和门店的位置却接不上。
这轮先画了平面关系:道路在前,路沿和人行道在车后,门店再往后。车位平行路沿,车头统一向左,机位保持在道路对面。
接着按这套位置生成:缓行停稳、驾驶侧开门、下车关门、沿车侧走到车尾,再绕上人行道。观众能看见人怎样从车旁走到店门口。
这一段仍用到了后期。走路片后半段的店招文字发生变形,最后把正确首帧里的“清”字跟踪到对应位置,保留其余画面。车内对白里不自然的冷光,也另外做了色温与曝光校正。
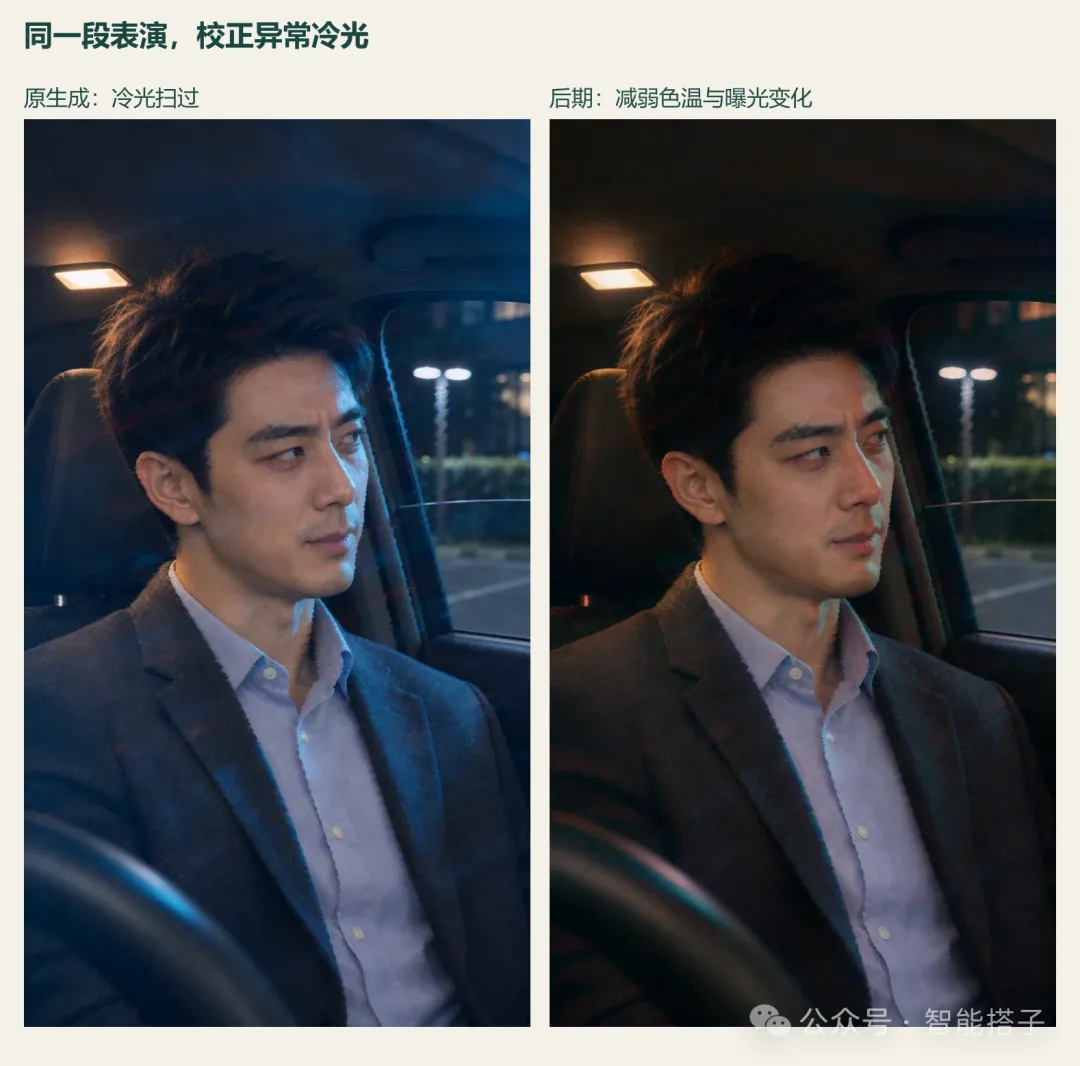
这些修改没有重新生成台词或人物动作。它们解决的是具体画面问题,也说明这版成片包含了逐镜选择和后期处理,不能把最终观感全部算成一次生成的结果。
两个人先定声音,再让镜头跟着对白走
声音这次换了制作顺序。
先用本地Qwen3-TTS准备陈屿、周航两套虚构男声,再分别生成原剧本对白。同一角色继续沿用同一套声音参考,旁白也保留陈屿的声线。
然后把人物首帧和固定对白音轨送进H3工作流,让画面按这段音频生成嘴部表演。最后剪辑时,仍使用原先那条独立对白轨,把环境声、关门声和脚步声放在下面。
这样接起来,角色声音的来源固定了,某条视频额外生成的尾音也不会混入整集。对白保持原速,没有为了缩短片子统一加速。
音轨固定以后,嘴型还需要单独看。我会重点检查开口、句尾收口,以及转头时嘴部有没有继续乱动。声音统一和表演自然,是接下来还要分别判断的两件事。
这套音频引导接法用了本期的本地工作流适配。只打开OpenMontage面板,声音和同步流程不会自行配好。
精修花了多久?视频生成累计约5小时35分钟
这次机器仍是RTX 5070 12GB显存、32GB内存,使用本地H3 INT8和Turbo六步路线。主要生成源片是768×1376,成片输出1080×1920、24帧;导出尺寸比源片大。
为了做出文中这版约1分52秒的精修片,我回查了这次重制的执行记录:44次已记录的视频生成尝试,工具执行耗时累计约5小时35分钟。其中包含后来没有采用、重新生成或被替换的试片,返工也算在内。
这个数是各次本地H3视频生成工具的执行时长相加,包括模型运行和结果取回等环节,不是纯GPU采样时间,也不等于从开始制作到拿到成片,只过了5小时35分钟。
其中一轮12条定向补镜就累计约102分钟。下面几条记录,能看出等待大概花在什么地方:
还有一部分时间不能漏掉:Codex调用大模型分析剧本、规划分镜、改提示词和代码,需要等待;首帧图像生成、Qwen配音、最终渲染,以及人来审片、挑镜头、调整剪辑,也都要花时间。这些环节没有完整合并计时,所以我目前只能给出可核对的视频生成累计耗时,不能报一个精确的全部制作总工时。
换句话说,5小时35分钟只覆盖已经记录的视频生成环节。真要评估自己能不能做这类片子,还得把大模型调用和人工修改的时间一起留出来;不同硬件、模型和返工次数,结果也会不同。
这也解释了上篇为什么先发初测。多留几个走路、拿放道具的镜头,片子只长了一点,背后却要多准备首帧、多等几条生成,再检查能不能接起来。
它本身支持讲解视频,我用PoseSwap试了一条
OpenMontage本身就支持制作讲解视频。项目说明(https://github.com/calesthio/OpenMontage#pipelines)里列有动画讲解、软件演示等制作流程,可以由Agent组织脚本、旁白、画面、字幕和最终合成。图片配旁白、再通过Remotion编排成片,也是它提供的制作方式之一。
所以这次除了继续精修短剧,我也想试试:把已经做过的实测交给它,能不能制作一条把操作和结果讲清楚的教程?前面那期PoseSwap正好有现成素材,我就拿它测试这项能力,单独建了一个横屏讲解项目。
这次用的是现代瑜伽服人物原图、六张换姿换装结果、参考图库宫格和完整的ComfyUI操作界面截图。制作时沿用阿洁固定的Qwen配音,再用Remotion合成,看看已有素材能怎样组织成一条完整讲解。
这条片子要回答三个问题:人物和参考图怎么接?换姿、换装分别改变了什么?两步连起来以后,姿势还能保留多少?
所以开头直接并排放原人物、侧身结果和西装结果,先让观众看到效果。后面再依次讲换姿、换装和串联,把“输入什么、得到什么、哪里发生了变化”放在同一幅横屏画面里。
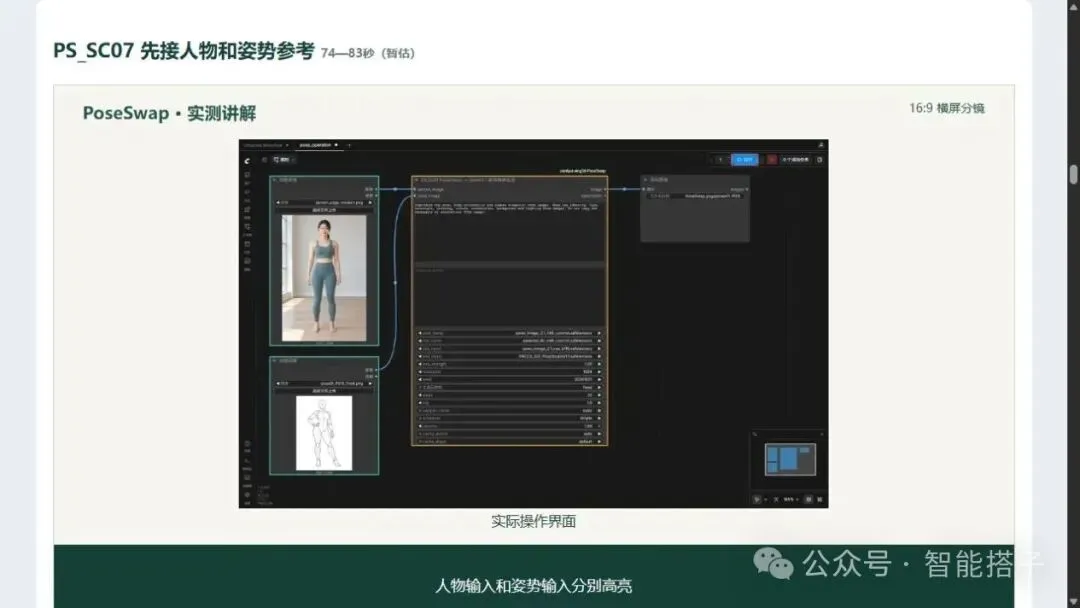
制作时先把内容拆成14段口播,每段对应一组真实素材和一个要讲清楚的点,再做视觉分镜。像节点连线这一段,就保留完整操作截图,用彩框指出人物、姿势和输出的位置;讲效果时,则换成完整人物的并排对照,手脚也能一起看。
分镜确认后,用阿洁固定的Qwen声音生成原速旁白,再按每段音频的实际长度安排画面和字幕。最后通过OpenMontage调用Remotion合成,输出1920×1080、30帧,成片约4分59秒。
这里没有让H3重新生成换装人物,也没有把截图做成假操作录屏。换姿换装结果来自之前的真实复测,视频里的工作,是把这些结果、界面和解释接起来。串联部分也讲清楚了:连线已经核验,54秒只指后一步换装,不是整条流程一次运行的总耗时。
做这类讲解,我最需要的是素材对应得上,旁白讲到哪儿,画面就让人看到哪儿。横屏可以同时放人物、参考和结果,这次选它有具体用途;短剧里的走路、拿串和停车问题,仍然要靠镜头本身解决。
两条片子做下来,OpenMontage承担的工作是相通的:保存方案、口播或剧本、分镜、素材和合成记录,让Agent能接着修改。真正决定画面质量的环节则不同——短剧要盯人物表演和动作连续,讲解片要盯内容顺序、图文对应和停留时间。
想照着试,我会先做这一个小场景
如果已经装好OpenMontage和可用的本地H3环境,我建议先选两个人、一张桌子、一句对白,跑完一小段,再决定是否展开整集。
准备人物参考、一个清楚的场景首帧,以及已经确定的对白。首帧里就放好椅子、杯子和餐碟,并说明人物在桌子的哪一边。
给Agent的任务,可以先写得这么具体:
制作任务约束,可修改使用
制作一个双人桌边短镜头,先验证这一段,再扩展后续剧情。
沿用两个人物的参考图,固定服装、左右座位和场景机位。
使用我提供的原速对白音轨,人物朝对方说话。
画面里只做一个主要动作:从碟中拿起烤串,举到胸前。
保持同一只手,茶杯和餐碟位置不变,食物不接触裸桌面。
先给出首帧、结束状态和工作流接法,再运行本地生成。
出片后检查人物、手、道具、对白起止,再决定是否接下一镜。
这里最有用的准备,是把“这条拍完以后,人和道具应该在哪里”提前说清楚。要拿起物品,就把物品和容器放进首帧;要离开,就把终点定为人物出画;要接下一场,就让上一场的离开方向和下一场的进入方向能接上。
我的结论:能推进制作,短剧还得人工剪
OpenMontage能做什么?这次两条片子验证到的是:它可以让Agent把剧本或讲解内容拆成分镜,组织已有素材或调用模型生成新素材,再安排配音、字幕和最终合成。哪条镜头要换、声音用哪一版、合成从哪里继续,都能留在项目里,适合反复修改。
做到什么程度?有现成实测图和界面的PoseSwap讲解,已经做出了一条约5分钟的完整横屏视频。短剧这边,也能把多个生成镜头接成完整一集,精修后的动作交代和声音一致性比上篇明显进步。
但这次短剧精修版,还不能直接当作发布成片。人物动作、镜头衔接、口型和整场戏的节奏,仍然需要人看、人工挑片和剪辑;有些问题还要回去补镜。能导出一条完整MP4,和剪出一条看着顺、愿意发布的短剧,中间还有一段工作。
如果有时间还可以让它继续改,但是我觉得没有意义。
所以,我会把OpenMontage用在组织制作、生成素材和形成初剪上,最终发布前保留人工精剪这一环。想拿它做图文实测讲解,可以从自己已有的素材开始;想做连续剧情,就要同时准备好模型运行的等待和人工剪辑的时间。
项目入口:OpenMontage(https://github.com/calesthio/OpenMontage)。本地模型说明:MiniMax H3(https://huggingface.co/Comfy-Org/MiniMax-H3),加速节点:H3 Turbo(https://github.com/Larryvrh/ComfyUI-MiniMax-H3-Turbo)。
智能搭子 · 和你一起把AI真正用起来
真实体验 · 客观判断 · 持续探索

